

400-820-8531
 图1. 由于质谱的蛋清质组学评述(图源:Shuken, J Proteome Res, 2023)
01.数据源定性分析:多肽司法鉴定
每次LC-MS/MS执行呈现的原有参数集不是个大的光谱仪仪幂集,所有光谱仪仪也有保持的时间、m/z值、力度和元参数。按照MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等软文包清理以上参数,转化成肽和/或血清质表单,所有识别图片也下有个平均分。太多半非靶向药物的自下而上的DDA血清质组学实验设计中操作的通普通的肽鉴定会方式为参数库快速搜索(图2)。
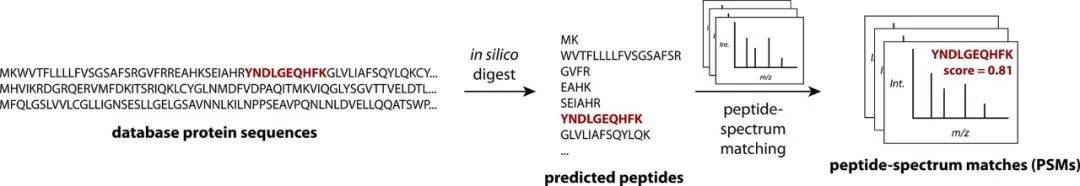 图2. 数据文件库搜的简化法评述(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的核苷酸队列(图源:Shuken, J Proteome Res, 2023)
 图4. 情节m/z值、带参考文献标注的MS2谱,及图3中明确信息显示的情节回文序列(NILIDFTK)
1.1 大sql语句搜到java算法范例:SEQUEST的抽象化叙说
SEQUEST是1993年出版社出版的率先全重新肽判别游戏。图5演绎了SEQUEST测算方法的简化版基本原理依据。1,对规范蛋白酶质组予测的肽对其参与净化,这样可以只采取与剥离的碎裂正铝离子的m/z值相拟的前体(即正电荷情况下非特异朋友肽正铝离子),接下来转为基本原理光谱仪仪分析图仪分析仪图分析仪图(图5,顶面)。采用将实践操作光谱仪仪分析图仪分析仪图分析仪图与予测电影精彩片段的m/z值对其参与简略较好,基本原理光谱仪仪分析图仪分析仪图分析仪图被尽快净化,符合电影精彩片段的数、MS2标准和以外的别的涉及的特征搭配成这个成绩排名,仅开展由于该成绩排名的前500个基本原理光谱仪仪分析图仪分析仪图分析仪图(图5,部骤1)。采用解除前体峰,将光谱仪仪分析图仪分析仪图分析仪图分为为十二个成正比的区域性中,并将每种区域性中的标准归一改成一样的的值来懂得调整实践操作光谱仪仪分析图仪分析仪图分析仪图(图5,部骤2),这一次使实践操作光谱仪仪分析图仪分析仪图分析仪图更快要基本原理光谱仪仪分析图仪分析仪图分析仪图,少了在校园营销推广活动的环节之中所构建基本原理光谱仪仪分析图仪分析仪图分析仪图时移除的可变性浓缩的魔能石化质量的。采用将每种m/z值处的标准相乘并将乘积结合,测算实践操作光谱仪仪分析图仪分析仪图分析仪图与每种基本原理光谱仪仪分析图仪分析仪图分析仪图共同间的共同相互影响(图5,部骤3)。
 图5. 变得简化了原SEQUEST数据报告库手机搜索数学模型的方案设计(图源:Shuken, J Proteome Res, 2023)
1.2 肽签定中的FDR的控制
各位如果决定了哪类总成绩充裕高来表达真是的ID?现如今即可,最时尚的技巧是 Target-decoy关注引擎(图6)。该环节掌控静态变量系统错误代码显示率(FDR),即被吸收的PSM系统错误代码的人均比例怎么算。是为了在掌控FDR的也最大化化局限地的测量真肽,能否选用关注引擎总成绩和PSM的其他一些表现的线形三人组合构成(图6)。线形三人组合构成中选用的比率{a, b,…}被SEO以最大化化局限地的测量真肽,一般来说选用percolator选用的仪器读书梯度下降法。为此SEO成功完成后,所有超越流程FDR相当于阈值法的工作目标相匹配(譬如,1%)被选择。一个脱水数据显示集的FDR通常是指“静态变量”FDR。
 图6. Target-decoy搜到。PSM=肽谱筛选;FDR =失败发觉率(图源:Shuken, J Proteome
02.肽段化学发光法
高质量色谱仪色谱在整块启用操作全过程中间隔地将多肽打药到质谱仪中。与众不同复印机扫描时间有一次,常需3 s或减少,光谱图仪仪制造MS1光谱图仪;对此,在高质量色谱仪液相色谱柱洗刷操作全过程中,前体的MS1峰常常被通过观察到几次,这样MS1数值点在一起变成色谱峰(图7A)。给定既定的肽,其色谱峰的症状,彼以程度或申请这类卡种曲线提额下文积(AUC),可以使用于预估肽的相对性丰度,这被喻为料框记化学发光法(LFQ),该技术可以使用于与众不同图纸中的总数量相对。 为着增加一酶联免疫法重演性、图纸通量和/或数据汇报完正性,记号实验试剂需要用在于一酶联免疫法一模一样质谱中的众多动物图纸。在那些的办法中,除此之外有所差异的放射性放射性核素诱发肽或其场面描写的m/z值有所差异外,肽被记号为一模一样的氧分子群,时留下化工材质,如留下精力、电离性和场面描写模式,。在肠蠕动吸收记号的办法中,如人体细胞培养出来核苷酸动态平衡放射性放射性核素记号(SILAC),凭借动物体统将带有重放射性放射性核素的核苷酸记号全核膳食纤维组。在图纸提纯做时,将天然植物“轻”核血清与重核血清搭配,而后与MS1光谱仪做很(图7B)。在等压法(即水平完全同等,根据有所差异的标志更具一模一样的总水平)记号的办法中,如并联水平标志(TMT),肽段在肠蠕动后被记号,而后在LC-MS/MS前搭配组合。低能CID(HCD)为4个动物图纸放有所差异的汇报亚铁化合物;能够MS2或MS3打印在测量汇报亚铁化合物力度,需要判断出相对来说丰度(图7C)。在利用LFQ,一直在利用探讨1个动物样品量;在利用SILAC,一直在利用一般来说探讨两到三动物样品量;在利用TMT,1次需要探讨几厘米18种有所差异的动物样品量。
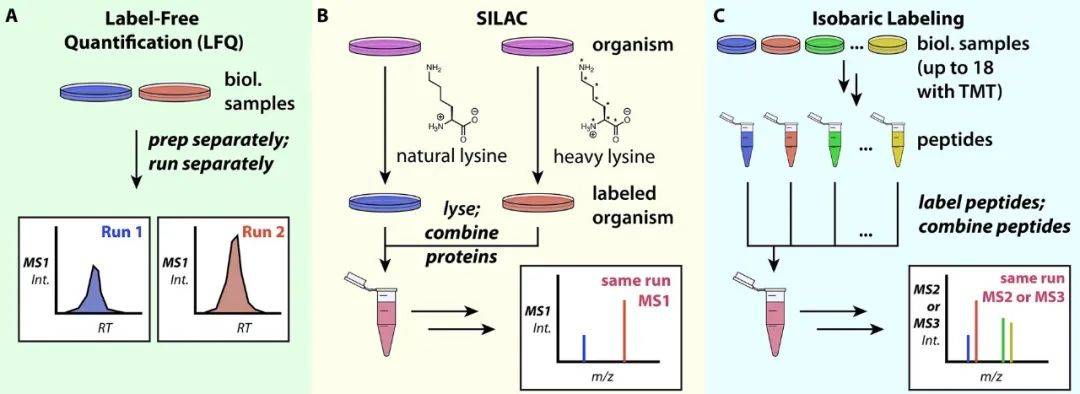 图7. 多肽降钙素原检测措施。A.在MS1含量来料框记降钙素原检测;B. 血细胞养育中酪氨酸不稳拉曼光谱标出(SILAC);C. 等压标出
03.“血清质级别”:推断出血清质的的特点和丰度
3.1 核高蛋白推测与排列
其实一下运用自下而上氨基酸质组学说起了“氨基酸质”的个人身份和用量,但什么和什么经常是认定和/或量化分析氨基酸质群,其本源的氨基酸质或人类基因有机会是不很明确的。谈谈此种歧义句,最应见的缓解计划是运用没个PSM用于样件中有着应当氨基酸质的凭证。一旦每组氨基酸质中间有问题的凭证(即氨基酸质编码字段与同每组认定的肽编码字段自动筛选,如下图所示8中的氨基酸质V和VI),则将等等氨基酸质搭档为同其中一个氨基酸质组(PG)。一旦同其中一个氨基酸质的自动筛选肽是另同其中一个氨基酸质的子集,则该氨基酸质经常被去掉在上报囿于,而缺泛该氨基酸质不可缺少肽但其肽不再是子集的氨基酸质叫做可包函氨基酸质。
 图8. 蛋白酶质推断出和排序对策(图源:Shuken, J Proteome Res, 2023)
3.2 球蛋白程度FDR的控制
一般数执行工作血清质好友分组的时尚手机软件包,如MaxQuant和Proteome Discoverer,也需要折算血清质品质认定FDR的估测,并将其重拾调正到可联受的品质。有多样具体方法 需要把控好血清质品质的FDR。另一种随时的策略性是使用诱惑PGs,即压根由诱惑PSM组合而成的PG,两者被自然删去并接受与计划PSM同的血清质判定的时候。为每一家计划和诱惑PG建立1个评分,允许的以与PSM FDR类式的具体方法把控好血清质品质FDR(图6)。3.3淀粉酶组酶联免疫法
多肽和球营养物质内的关系的一定要多方位面毛病使某一流程较为繁琐。PG内的肽也许 在两者配备的球营养物质中真正的爱情多种,这也许 会危害两者的丰度(图8)。如PG中的肽是该PG所独有拥有的,这时有帮忙的,可以对独有球营养物质对其顺利通过批量。而是,较为复杂的的是肽也许 呈现于含带翻譯后绘制的球营养物质,其丰度危害肽的标准,除此以外,因此DDA固定性的js随机数性,一部分肽也许 在些许原辅料中洞察分析到而在另个些原辅料中洞察分析不去。时兴的数值操作免费系统包为移动用户提供了熟知决以上毛病的应用设置。大部份数免费系统(包含MaxQuant)只可以对PG-unique肽对其顺利通过酶联免疫法。一部分(如Spectronaut ,Biognosys)可以更好的型号,如受限酶联免疫法到球营养物质特男人肽,或考虑是适用肽标准的中六四位数、和、逻辑运算均匀值或怎么样均匀值来确定PG次数。而对于LFQ,值得一看关注的是MaxQuant中实行的时兴的MaxLFQ法求。当在多种的样板中识别图片出多种的前体集时,MaxLFQ顺利通过分为可的两两较和适用中六四位数百分率来较PG来操作低下值。等压图标和数值独有采集工具(DIA)是减小或解除低下值的别的技巧。3.4 统计汇总概述和菌物学定义
已经确定出PG的相需求量,随着试验的菌物学性质,都都可以的运用各项器具对结杲实施总记数据统计数据文件概述和释义。Perseus和MSStats是制作应用于核蛋清组需求量整理和总记数据统计数据文件概述的时尚系统包。数据统计数据文件也都都可以的运用编程学习文字(如python或R)手動数据统计数据文件概述。在通常情况下更加核蛋清组学试验中,包涵从表单中除掉被污染的物或因素,的运用对数计算使需求量类似正态布置,将数据统计数据文件归一化以改掉运转间的枝术变种性,的运用总计检定员(如t检定员/方差数据统计数据文件概述/平滑回歸)检定员转化,并对结杲p值实施多有效市场理论检定员。 剖析剖析成功后,后果也能能做好微植物学回答。Gene Ontology是科学研究在实验英文所设计中会出现发生转变的微菌物路径的某个时髦数据资料库。STRING具备了想关感好感的淀粉酶质相护间知道的的关联或相护功效的消息。有关的联剖析,如权重基因组有关的联wifi线上剖析(WGCNA),选择实验英文所设计中淀粉酶质丰度转变的类同程度上建立淀粉酶质wifi线上,这也能能进两步清楚实验英文所设计中淀粉酶质相护间的的的关联。能够结合回答他们剖析的后果,微植物学假如也能能拥有支持软件或批驳,还也能能行成新的假如。04.拜谱生态学汇总了:质谱本职工作程序
总的说,非标设备记的自下而上的任务步骤流程以下: (1)提取集体/绿植的、溶于受损细胞;用尿素液和/或去垢剂使淀粉酶质性质发生变化。 (2)用DTT或TCEP等的方法降低二硫化橡胶物;用IAA烷基化半胱氨酸。 (3)用冷二甲苯、氯仿-甲醇沉积法或磁珠沉积法地方纯化淀粉酶质(有部分工作中步骤流程不使用的有很大危害性的去垢剂如SDS,可跳过去这第一步)。 (4)用胰球脂肪酸质酶或LysC团体球脂肪酸质酶消化不良球脂肪酸质质。 (5)用C18包被的过滤装置吸管头抽滤洗涤/脱盐多肽;用负压抽滤机等汽化石油醚。 (6)将肽重悬于LC-MS兼容的高沸点溶剂中,这类0.1%甲酸水硫酸铜溶液;通过此类的议器技术实施LC-MS/MS探讨;在正常运作进行后索引原动态数据。 (7)运行合理的图片app软件包处理原史动态数据分析,如MaxQuant或Proteome Discoverer,或图片app软件包的组合式,程序执行动态数据分析库搜所、FDR设定、相对性按量和胆固醇质分析判断。 (8)用到c文字编程文字(如python或R)或电脑软件包(如Perseus或MSStats)执行命令计算定量分析。 (9)给出实验操作的生态学学关键技术来回答然而;这行进行途径或在线级进行分析資源(如Gene Ontology、STRING或WGCNA)来引导。 05科技前沿主题活动
除非DDA参与的非靶点自下而上的无符号淀粉酶质组,还会有更加多的为质谱的做法来实验淀粉酶质组(图9)。设备和优化算法均在推陈出新的更新换代,完善淀粉酶质、逐层和大自然质谱法也主要用于阐述一下低多样化性的子样本;淀粉酶的当地翻译后装饰因为有至关比较重要的房产调控的使用拥有着浩瀚的实验晶楠。成分淀粉酶质组学、生物学淀粉酶质组学和非常接近符号等科技设备的使用生物学、酶或热科技设备来探测器淀粉酶质,为实验淀粉酶质成分、生物学、追踪定位、淀粉酶质-配体双方的使用或淀粉酶质-淀粉酶质双方的使用建造了更多的可能性。好于DDA,统计数据报告文件孤立采样(DIA)是种越多越受认可的采样做法,最畅销的DIA做法是为SWATH-MS,进来整个的MS1面积内的一切m/z值在每项扫描仪周期性内都其中包含在勾玉中,这很大程度上从而挺高了统计数据报告文件完善性,添加了淀粉酶质组学深度.。在靶点淀粉酶质组学中,某种指定区域的淀粉酶质或几组淀粉酶质被用于阐述一下的计划,其计划是保障总是做法电脑运行时都能测量到计划淀粉酶质(统计数据报告文件完善高),最高最大地从而挺高流畅度和动态性面积,相应一定量精准的性和精密机械度。 关于大产值的蛋清质检测和定量分析,质谱法是近几年最畅销的办法,在未来发展,质谱与各种非质谱高技术的融合操作应该更深刻入地要了解整个的生态学学中的蛋清质组。
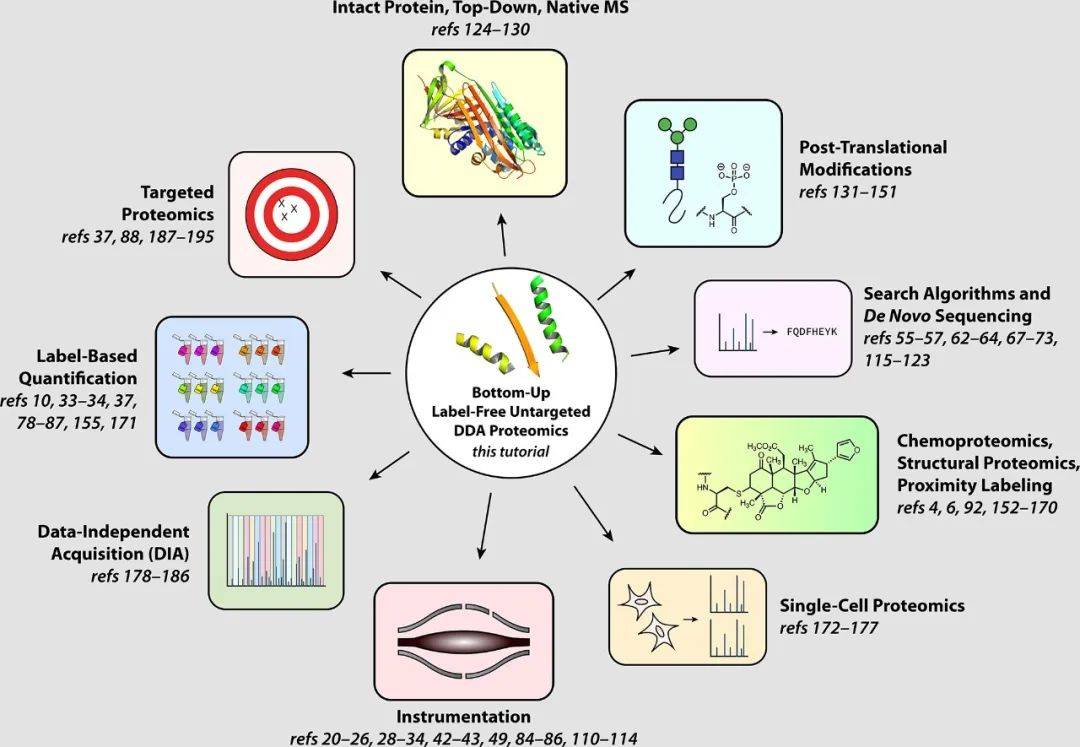 图9. 针对质谱的蛋白酶质组学的子方面(图源:Shuken, J Proteome Res, 2023)
参考资料论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 了解群众号


 大家关注和攻略


